
머신 비전 분야에서 기본적인 요구 사항 중 하나는 서로 다른 이미지의 색상 성분을 분리하는 것입니다. 예를 들어 RGB를 각 성분으로 분리하는 것뿐만 아니라, HSL이나 XYZ 등의 색상 공간도 분리할 수 있습니다. 다음에서는 색상 분리에 대한 몇 가지 예시를 보여드립니다. 모든 예제에서는 RGB 면 스캔 카메라를 입력으로 사용합니다. 물론, 이 예제들은 라인 스캔 카메라에도 적용할 수 있습니다. 또한, 사전 베이어 디모자이징(Bayer De-Mosaicing)이나 색 공간 변환이 필요할 수 있으며, 이를 예제에 쉽게 추가할 수 있습니다.
이 예제들은 호스트 PC에서 후처리를 위해 색상 분리가 필요하다고 가정합니다. 따라서 이 예제들은 색상 분리된 데이터의 DMA 전송에 중점을 둡니다. FPGA 내에서 색상 분리된 데이터를 처리해야 하는 경우에도, 이 예제들을 귀하의 요구 사항에 맞게 적용할 수 있습니다.
몇 가지 예시가 제시되어 있습니다. 모든 예시의 결과는 동일합니다. 그러나 구현 방식은 완전히 다르며, 각각 장단점이 있습니다. 자신의 요구 사항에 가장 적합한 예시를 선택해야 합니다. 다음 표에는 모든 예시와 일부 속성이 나열되어 있습니다.
| 예시 이름 | Latency | DRAM | 블록 RAM 개수 | DMA 출력 |
|---|---|---|---|---|
| 3개의 DMA | 추가 지연 없음 | 1개의 DRAM 버퍼 | Low | 3개의 DMA. 각 색상 구성 요소마다 하나씩입니다. |
| 3개의 버퍼를 갖춘 순차형 | 지연 시간이 이론적 최소값까지 최소화되었습니다. | 3개의 DRAM 버퍼 | Low | 1 DMA. 순차적 색상 구성 요소 출력. |
| MultiROI 버퍼를 사용한 순차 처리 | 1 프레임 지연 및 대역폭 제한. | 1개의 DRAM 버퍼 | 일반 | 1 DMA. 순차적 색상 구성 요소 출력. |
| 사전 정렬된 MultiROI 버퍼를 사용하는 순차 처리 | 1 프레임 지연 시간 | 1개의 DRAM 버퍼 | High | 1 DMA. 순차적 색상 구성 요소 출력. |
| 고급 버퍼 사용 기능을 갖춘 순차 처리 | 1 프레임 지연 시간 | 1개의 DRAM 버퍼 | Low | 1 DMA. 순차적 색상 구성 요소 출력. |
표 20. 색분리 예시 개요
이전 표에 제시된 속성에 대한 자세한 설명과 다양한 방법에 대한 상세한 설명은 다음 절에서 다루고 있습니다.
| 간략한 설명 | |
|---|---|
|
파일: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option1_ThreeDMA.va |
 |
|
기본 플랫폼: mE5-MA-VCL |
|
|
요약 설명 RGB 색상 평면 분리 예시. 각 구성 요소는 세 개의 DMA 출력 채널로 분할됩니다. |
|
이 예제는 매우 간단합니다. 입력 RGB 이미지가 버퍼링된 후, 색상 평면이 세 개의 출력 링크로 분할됩니다. 이 세 개의 링크는 세 개의 DmaToPC 연산자를 사용하여 PC로 전송됩니다. 이 솔루션의 장점은 지연 시간이 최소화된다는 점입니다. 이미지는 프레임 그래버에 버퍼링되지 않습니다. 호스트 PC의 성능이 충분히 빠르면 ImageBuffer 연산자는 이미지를 한 라인만큼만 지연시킵니다. 추가적인 지연은 발생하지 않습니다. 또 다른 장점은 DRAM 연산자가 단 하나만 필요하다는 점입니다.
이 구현 방식의 단점은 3개의 DMA 출력 연산자가 필요하다는 점입니다. 이러한 연산자들은 프레임 그래버의 FPGA 로직 리소스를 많이 소모합니다. 만약 이처럼 지연 시간을 최소화할 필요가 없다면, 다음 장에서 제시된 해결책 중 하나를 고려해 보시기 바랍니다.
| 간략한 설명 | |
|---|---|
|
파일: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option2_ThreeBuffersOneDMA.va |
 |
|
기본 플랫폼: mE5-MA-VCL |
|
|
요약 설명 RGB 색상 평면 분리 예시. 각 구성 요소는 세 개의 프레임 그래버 버퍼로 분할되어 저장됩니다. 그 후, 하나의 DMA 채널을 사용하여 색상 평면이 순차적으로 출력됩니다. |
|
RGB 색상 평면 분리를 위한 이 솔루션에서는 색상 평면이 DMA 채널을 통해 순차적으로 출력됩니다. 이는 RGB 입력을 각 구성 요소로 분할하고, 세 개의 ImageBuffer 모듈에 색상을 각각 별도로 버퍼링함으로써 이루어집니다. 연산자 InsertImage를 사용하여, 색상 평면이 ImageBuffer에서 차례로 읽혀집니다.
이 예제에서는 데이터를 ImageBuffer에 기록하기 전에 병렬 처리 수준을 높이는 것이 중요합니다. 그렇지 않으면 InsertImage 모듈 이후에 병목 현상이 발생합니다.
이 방식의 장점은 DMA 채널이 하나만 필요하므로 필요한 리소스를 줄일 수 있다는 점입니다. 또한, 순차 출력 시 지연 시간은 이론상 최소값을 기록합니다. 빨간색 채널에 대한 DMA 전송은 지연 없이 즉시 시작됩니다. 이 솔루션의 단점은 세 개의 프레임 그래버 메모리 연산자가 필요하다는 점입니다. 이러한 버퍼의 수가 제한되어 있으므로, 더 많은 버퍼가 필요하지 않은 경우에만 이 솔루션이 유용합니다.
| 간략한 설명 | |
|---|---|
|
파일: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option3_SequentialMultiROI.va |
 |
|
기본 플랫폼: mE5-MA-VCL |
|
|
요약 설명 RGB 색상 평면 분리 예시. 세 가지 RGB 색상 평면에 대한 순차적 DMA 출력이 수행됩니다. 이 순서는 ImageBufferMultiRoI에 의해 생성됩니다. 이 방법은 대역폭을 제한하므로 바람직하지 않습니다. 최적화된 해결 방법은 다음 예제를 참조하십시오. |
|
이 해결책은 이전 예제와 다음 예제 사이의 중간 단계에 해당합니다. 대역폭 제한으로 인해 이 해결책을 구현하는 것은 권장되지 않습니다. 하지만 이 예제는 프레임 그래버 RAM 하나만으로도 이전 예제와 동일한 출력을 얻는 방법을 간단하게 설명합니다. 이미지를 순차적으로 처리하기 위해 ImageBufferMultiRoI 연산자를 사용합니다. 이 연산자에서는 동일한 이미지를 세 번 읽기만 하면 됩니다. 그 후, 첫 번째 이미지의 빨간색 성분, 두 번째 이미지의 녹색 성분, 세 번째 이미지의 파란색 성분을 각각 선택합니다. 이는 ModuloCount 및 CASE 연산자를 사용하여 쉽게 수행할 수 있습니다. ModuloCount는 프레임 번호를 3으로 나눈 나머지(즉, {0, 1, 2, 0, 1, 2, ...})를 계산하도록 매개변수화되어 있습니다.
앞서 언급했듯이, 이 해결책은 대역폭을 줄이기 때문에 최적의 방법은 아닙니다. 그 이유는 동일한 입력 이미지를 세 번 읽지만, 세 구성 요소 중 하나만 사용하기 때문입니다. 따라서 매 읽기 주기마다 데이터의 3분의 2를 버리게 됩니다. 다음 예제에서는 이러한 한계를 극복한 유사한 해결책을 보여드리겠습니다.
| 간략한 설명 | |
|---|---|
|
파일: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option4_SequentialPreSortMultiROI.va |
 |
|
기본 플랫폼: mE5-MA-VCL |
|
|
요약 설명 RGB 색상 플레인 분리 예시. 세 가지 RGB 색상 플레인에 대한 순차적 DMA 출력이 수행됩니다. 이 순서는 ImageBufferMultiRoI에 의해 생성됩니다. 추가적인 사전 정렬을 통해 대역폭을 최적화하고, 이전 예시에서 제시된 문제를 해결합니다. |
|
이 예제는 앞의 예제와 비슷합니다. 다만, 이 경우에는 대역폭 제한이 없습니다. 기본 원리는 동일합니다. ImageBufferMultiRoI 연산자를 사용하여 세 가지 색상 성분을 순차적으로 처리합니다. 이전 예제와 달리, 버퍼 처리 후 색상을 분리하지 않습니다. 대신 버퍼에 기록하기 전에 색상을 분리합니다. 이는 다음 그림에 내용이 표시된 HierarchicalBox PreSort에서 수행됩니다.

이 접근 방식의 핵심은 색상 성분들을 버퍼에 기록하기 전에 분리하는 것입니다. 이 작업은 이미지의 모든 라인에 대해 수행됩니다. 따라서 색상 성분들을 세 개의 링크로 나눕니다. 이렇게 생성된 그레이스케일 링크에는 이제 입력 이미지의 각 라인이 포함됩니다. 다음으로, 각 라인을 다중화하여 연결합니다. 그 결과, 하나의 큰 이미지 안에 세 개의 그레이스케일 이미지가 포함됩니다. 빨간색 성분은 왼쪽에, 녹색은 가운데에, 파란색은 오른쪽에 위치합니다. 구현 방식을 이해하려면 다음 그림의 시뮬레이션 결과를 살펴보시기 바랍니다.
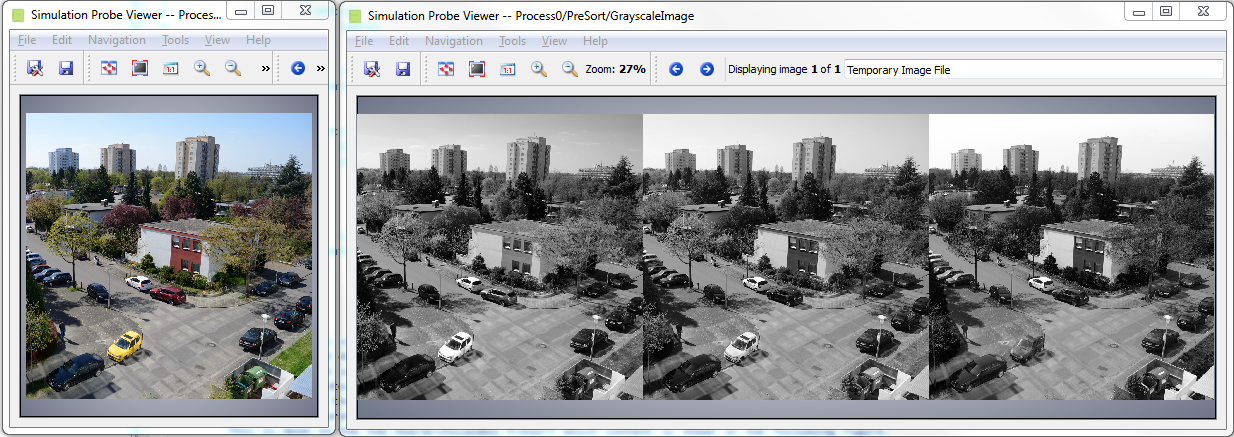
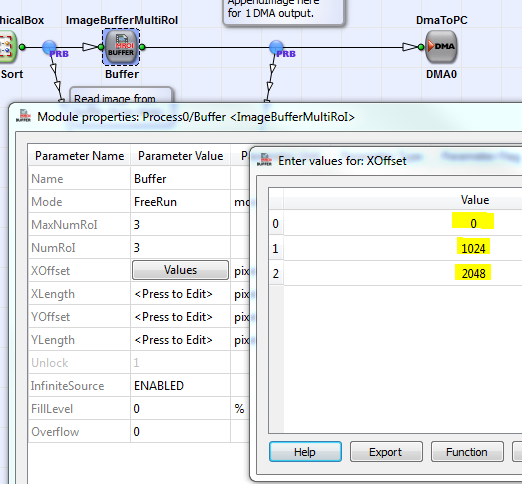
ImageBufferMultiRoI에서는 이제 왼쪽 부분을 먼저 읽어야 합니다. 그 다음에는 가운데 부분을, 마지막으로 오른쪽 부분을 읽어야 합니다. 따라서 다음과 같이 각 ROI마다 서로 다른 XOffset을 설정해야 합니다.
사용 시, 예제에서 보여준 것처럼 구성 요소를 분리하기 전에 병렬 처리 수준을 높이는 것을 잊지 마십시오. 이는 InsertLine 모듈 이후의 병목 현상을 방지하기 위해 필요합니다. 더 이상 24비트 RGB 이미지가 아닌 8비트 그레이스케일 이미지를 전송하므로, 입력보다 최소 3배 더 높은 병렬 처리 수준이 필요합니다.
이 솔루션은 DRAM 연산기가 단 하나만 필요하며 대역폭에 제한이 없습니다. 이는 최적화된 솔루션입니다. 다만, FIFO 내의 분리된 구성 요소 라인을 버퍼링하기 위해 일부 블록 RAM이 필요합니다. 이미지 크기가 작은 경우에는 이로 인해 문제가 발생하지 않을 것입니다. 그러나 한 줄당 16384픽셀과 같이 이미지 너비가 큰 경우에는 많은 양의 블록 RAM이 필요합니다. 이 마지막 단점은 다음 예제를 통해 해결됩니다.
| 간략한 설명 | |
|---|---|
|
파일: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option5_SequentialAdvanced.va |
 |
|
기본 플랫폼: mE5-MA-VCL |
|
|
요약 설명 색상 평면 분리에 대한 예시. RGB 입력은 각 구성 요소로 분할된 후, 하나의 DMA 채널을 통해 순차적으로 출력됩니다. 이 분할 작업은 동일한 구성 요소들을 병렬 워드로 묶은 다음, FrameBufferRandomRead를 사용하여 읽어들이는 방식으로 수행됩니다. |
|
이것은 VisualApplets 에 소개된 색상 평면 분리 기법 중 가장 진보된 예시입니다. 이 예시는 리소스 사용량을 최소화하고 대역폭을 극대화하는 데 중점을 둡니다. 이전 예시에서는 색상 성분을 분리하기 위해 사전 정렬을 사용하여, 버퍼에서 각 성분을 개별적으로 읽을 수 있도록 했습니다. 그러나 사전 정렬 과정의 FIFO를 위해 일정량의 블록 RAM이 필요합니다. 이 접근 방식에서도 사전 정렬을 사용합니다. 다만, 다음 색상 성분으로 전환하기 직전에만 각 색상 성분의 연속된 8개 픽셀을 수집합니다. 이전 예제에서는 다음 라인으로 전환하기 전에 한 성분의 전체 라인을 수집했습니다. 이러한 수정으로 인해 더 이상 FIFO가 필요하지 않게 되었습니다. 다만, 이 경우에는 ImageBufferMultiRoI 를 사용할 수 없습니다. 대신 FrameBufferRandomRead를 사용해야 합니다.
사전 정렬 과정은 간단합니다. 먼저, 병렬 처리 수준을 8로 늘립니다. 다음으로, 구성 요소를 분할합니다. 그 결과, 각각 8개씩 병렬로 처리되는 세 개의 링크가 생성됩니다. 이제 MergeParallel이 각 구성 요소의 8개 픽셀을 시퀀스로 배열합니다. 따라서 다음과 같은 시퀀스를 얻게 됩니다: R0부터 R7까지, G0부터 G7까지, B0부터 B7까지, R8부터 R15까지, G8부터 G15까지, B8부터 B15까지, ...

입력에 FIFO가 필요한 이유는 16에서 8로 병렬 처리( PARALLELdn )되기 때문입니다. 이 FIFO는 DRC 레벨 2 오류를 방지하기 위해서만 필요합니다. 실제로 데이터를 버퍼링할 필요가 없으므로, 크기를 2픽셀로 매우 작게 설정했습니다.
픽셀을 미리 정렬한 후, 이 픽셀들은 FrameBufferRandomRead 연산자에 버퍼링됩니다. 이 연산자는 행 및 열 주소 입력을 받아 데이터를 무작위로 읽을 수 있게 해줍니다.
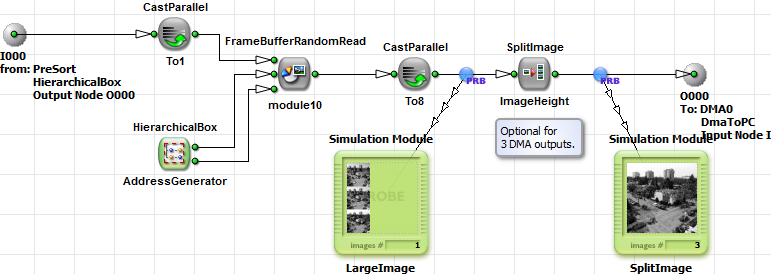
이 연산자는 병렬도 1일 때만 사용할 수 있습니다. 따라서 CastParallel을 사용하여 픽셀당 8비트인 병렬도 8에서 픽셀당 64비트인 병렬도 1로 형변환합니다. 이것이 바로 이전 단계에서 8개의 연속된 픽셀을 수집한 이유입니다.
색상 성분을 분리하려면 원치 않는 색상을 건너뛰기 위해 주소를 2씩 늘려야 합니다. 따라서 적색 성분의 읽기 주소는 다음과 같습니다: RColA(0) = 0, RColA(1) = 2, RColA(2) = 5, ... 녹색 성분의 경우, 읽기 주소는 다음과 같습니다: RColA(0) = 1, RColA(1) = 3, RColA(2) = 6, ... 계층적 박스(Hierarchical box)인 AddressGenerator는 이러한 읽기 주소를 생성합니다. CreateBlankImage 연산자는 필요한 이미지 크기를 정의합니다. 앞서 8에서 1로 CastParallel을 사용했기 때문에, 이미지 너비를 8로 나눈 값을 사용해야 합니다.

열 주소는 Coordinate_X 출력을 3으로 곱하여 간단히 생성됩니다. 현재 컴포넌트에 따라 값에 0, 1 또는 2를 오프셋으로 더합니다.
AppendImage를 사용하여 세 개의 주소 이미지를 하나의 더 큰 이미지로 병합합니다. 행 주소는 0부터 이미지 높이까지의 카운터를 사용하여 간단히 생성됩니다. 이 경우, 이 작업을 위해 ModuloCount 연산자를 사용합니다. 이제 이 주소들을 FrameBufferRandomRead 연산자에 입력할 수 있습니다. FrameBufferRandomRead의 성능을 극대화하기 위해 CreatBlankImage 출력에서 병렬도 2를 설정하는 것을 잊지 마십시오.
버퍼 처리 후, 첫 번째 줄에 빨간색 이미지가 포함되고, 그 다음 줄에는 녹색 이미지가, 마지막 줄에는 파란색 이미지가 포함된 큰 이미지를 얻게 됩니다. 이 큰 이미지를 세 개의 별도 DMA 출력으로 분할하기 위해 SplitImage를 사용하고 이미지 높이를 설정합니다.
구현 방식을 이해하는 가장 쉬운 방법은 중간 결과를 단계별로 살펴보는 것입니다. 하나의 결과 이미지를 얻기 위해서는 세 단계를 시뮬레이션해야 한다는 점에 유의하십시오. 이는 연산자에 의해 3개의 이미지가 생성되어야 하기 때문입니다 CreateBlankImage에 의해 3개의 이미지가 생성되어야 하기 때문입니다.
이 솔루션은 필요한 블록 RAM 리소스가 적기 때문에 리소스 효율이 높습니다. 또한, FPGA 로직 리소스도 효율적으로 활용됩니다. 주소 생성에 필요한 리소스는 극히 적습니다.
 이전

